دایرکتاکس ۱۲ و گرافهای کاری: انقلاب مایکروسافت در رندرینگ خودمختار و مبتنی بر پردازنده گرافیکی
DirectX 12 Work Graphs: Microsoft's Push for GPU-Driven Autonomous Rendering
گرافهای کاری دایرکتاکس ۱۲ (DirectX 12 Work Graphs) با انتقال مدیریت و زمانبندی وظایف از پردازنده مرکزی (CPU) به پردازنده گرافیکی (GPU)، گلوگاههای پردازشی را کاهش میدهند. این فناوری در Agility SDK مایکروسافت، رندرینگ خودمختار را ممکن ساخته و عملکرد هندسه رویهای و صحنههای پیچیده را بهشدت ارتقا میبخشد.
دایرکتاکس ۱۲ و گرافهای کاری: انقلاب مایکروسافت در رندرینگ خودمختار
مقدمه
صنعت گرافیک کامپیوتری و توسعه بازیهای ویدیویی همواره درگیر یک نبرد بیپایان برای بهینهسازی و استفاده حداکثری از منابع سختافزاری بوده است. در طول دهههای گذشته، یکی از بزرگترین چالشهای توسعهدهندگان، وابستگی شدید پردازنده گرافیکی (GPU) به دستورات پردازنده مرکزی (CPU) بوده است. این وابستگی باعث ایجاد گلوگاههای شدیدی میشود که مانع از بهرهبرداری کامل از قدرت عظیم گرافیکهای مدرن میگردد. اکنون، با معرفی گرافهای کاری دایرکتاکس ۱۲ (DirectX 12 Work Graphs)، مایکروسافت یک تغییر پارادایم اساسی را در معماری رندرینگ ایجاد کرده است.
این فناوری نوین که به عنوان بخشی از DirectX 12 Agility SDK معرفی شده است، به پردازنده گرافیکی اجازه میدهد تا وظایف خود را به صورت کاملاً خودمختار زمانبندی و مدیریت کند. در این مقاله جامع، ما به بررسی عمیق مکانیزمهای زیربنایی این فناوری، تاثیر آن بر کاهش گلوگاههای پردازشی، نحوه مدیریت هندسه رویهای (Procedural Geometry) و پشتیبانی سختافزاری توسط غولهایی نظیر انویدیا (NVIDIA) و ایامدی (AMD) خواهیم پرداخت. اگر به عنوان یک توسعهدهنده یا علاقهمند به تکنولوژی میخواهید بدانید آینده رندرینگ سهبعدی به کدام سمت میرود، گرافهای کاری دقیقاً همان نقطهعطف تاریخی هستند.
بافت و پیشزمینه
برای درک عظمت کاری که مایکروسافت با Work Graphs انجام داده است، ابتدا باید نگاهی به تاریخچه خط لوله رندرینگ (Rendering Pipeline) بیندازیم. در APIهای قدیمیتر مانند DirectX 9 و حتی DirectX 11، معماری به شدت مبتنی بر CPU بود. پردازنده مرکزی باید وضعیت رندر را تنظیم میکرد، بافرها را متصل میساخت و تک تک فراخوانیهای رسم (Draw Calls) را به GPU ارسال میکرد.

با ظهور DirectX 12 و Vulkan در سال ۲۰۱۵، ما شاهد معرفی APIهای صریح (Explicit APIs) بودیم. این رابطهای برنامهنویسی به توسعهدهندگان اجازه دادند تا از تمام هستههای پردازنده مرکزی برای تولید لیستهای دستور (Command Lists) استفاده کنند. علاوه بر این، ویژگیهایی مانند ExecuteIndirect معرفی شدند که به GPU اجازه میدادند تا حدی دستورات رسم خود را بر اساس دادههای تولید شده در سایهزنهای محاسباتی (Compute Shaders) اجرا کند.
«با وجود تمام پیشرفتهای دایرکتاکس ۱۲، پردازنده گرافیکی همچنان مانند یک کارگر فوقالعاده سریع بود که برای دریافت هر دستور جدید، باید منتظر تایید و زمانبندی مدیر خود (CPU) میماند. این رفتوآمد اطلاعات، تأخیر غیرقابل قبولی را در صحنههای پیچیده ایجاد میکرد.»
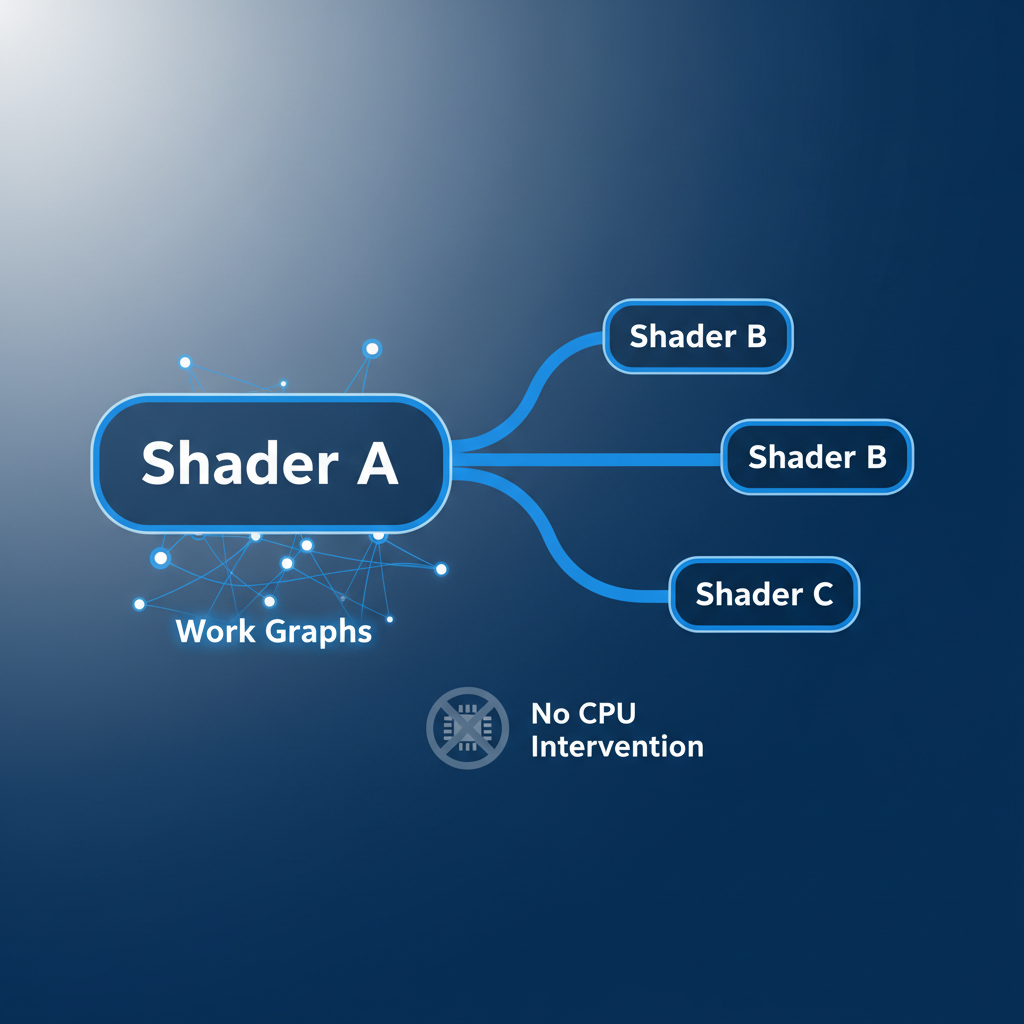
با پیچیدهتر شدن بازیها و نیاز به پردازش میلیونها مثلث در هر فریم (مانند تکنولوژی Nanite در موتور آنریل انجین ۵)، تکنیک ExecuteIndirect به محدودیتهای خود رسید. تخصیص حافظه در بدترین حالت (Worst-case memory allocation) و موانع همگامسازی (Synchronization Barriers) باعث اتلاف منابع میشد. اینجا بود که نیاز به یک سیستم کاملاً خودمختار (Autonomous) احساس شد؛ سیستمی که در آن یک سایهزن بتواند مستقیماً سایهزن دیگری را بدون نیاز به بازگشت به CPU فراخوانی کند.
جزئیات و تحلیل
مفهوم گرافهای کاری (Work Graphs) چیست؟
گرافهای کاری یک رویکرد کاملاً جدید برای اجرای کارهای محاسباتی روی پردازنده گرافیکی هستند. به جای استفاده از خط لوله سنتی خطی، وظایف در قالب یک گراف جهتدار (Directed Graph) سازماندهی میشوند. در این ساختار:
- گرهها (Nodes): هر گره نشاندهنده یک برنامه سایهزن (Shader) کوچک است که وظیفه خاصی را انجام میدهد.
- تولیدکنندگان (Producers): گرههایی که داده تولید کرده و کار جدیدی را درخواست میکنند.
- مصرفکنندگان (Consumers): گرههایی که دادههای تولید شده را دریافت کرده و پردازش میکنند.
- رکوردها (Records): بستههای اطلاعاتی (Payloads) که بین گرهها جابجا میشوند و حاوی دادههای لازم برای اجرای کار بعدی هستند.
- پشتیبان حافظه (Backing Memory): حافظهای که به صورت پویا توسط خود سختافزار مدیریت میشود تا رکوردها را در حین پرواز (In-flight) نگهداری کند.
در این معماری، وقتی یک گره کارش تمام میشود، میتواند به صورت پویا تصمیم بگیرد که کدام گره بعدی باید اجرا شود و چه تعداد رشته پردازشی (Threads) برای آن نیاز است. این فرآیند کاملاً در داخل سیلیکون پردازنده گرافیکی و توسط زمانبند سختافزاری (Hardware Scheduler) انجام میشود.
چگونه گرافهای کاری گلوگاه CPU را از بین میبرند؟
در رندرینگ سنتی، اگر بخواهید هندسه یک صحنه را فیلتر کنید (مثلاً حذف اشیایی که پشت دیوار هستند - Occlusion Culling)، پردازنده مرکزی باید درگیر شود یا باید از زنجیرهای از Compute Shaderها با موانع همگامسازی سنگین استفاده کنید. مراحل به این شکل است:
- پردازنده مرکزی (CPU) یک Compute Shader برای بررسی دید اشیاء ارسال میکند.
- پردازنده گرافیکی (GPU) محاسبه را انجام داده و نتایج را در یک بافر مینویسد.
- سختافزار باید منتظر بماند تا تمام رشتهها تمام شوند (Global Memory Barrier).
- سپس CPU یا یک دستور غیرمستقیم، فاز بعدی رندرینگ را بر اساس نتایج قبلی آغاز میکند.
اما با رندرینگ خودمختار از طریق گرافهای کاری، مراحل کاملاً دگرگون میشوند:
- یک گره اولیه (گره طبقهبندی) روی GPU اجرا میشود.
- برای هر شیء که قابل رویت است، این گره مستقیماً یک رکورد به گره رندرینگ ارسال میکند.
- زمانبند سختافزاری GPU بلافاصله و بدون هیچ مانع سراسری (Barrier)، رشتههای جدید را برای رندر کردن اشیاء قابل رویت راهاندازی میکند.
این فرآیند به این معناست که چرخه رفت و برگشت به CPU کاملاً حذف شده است و تأخیر (Latency) به حداقل ممکن میرسد.
«مایکروسافت با Work Graphs به پردازندههای گرافیکی اجازه داده است تا سرنوشت خود را در دست بگیرند. این فناوری نه تنها باعث افزایش فریمریت میشود، بلکه مصرف انرژی و حرارت تولیدی پردازنده مرکزی را نیز به شدت کاهش میدهد.»
کیت توسعه DirectX 12 Agility SDK
برای دسترسی به این قابلیتها، توسعهدهندگان باید از DirectX 12 Agility SDK استفاده کنند. مایکروسافت با معرفی نسخه 1.613 و بهینهسازیهای بعدی در نسخه 1.614.0، رسماً پشتیبانی از این ویژگی را به موتورهای بازیسازی آورد. این SDK به بازیسازان اجازه میدهد تا ویژگیهای جدید دایرکتاکس را مستقل از بروزرسانیهای سیستمعامل ویندوز به دست کاربران برسانند.
ویژگیهای کلیدی مرتبط با Work Graphs در Agility SDK عبارتند از:
- پشتیبانی کامل از Shader Model 6.8 که دستورات جدیدی برای مدیریت گرهها معرفی میکند.
- امکان استفاده از Node Broadcasting که در آن یک رکورد میتواند چندین گره مصرفکننده را فعال کند.
- پشتیبانی از Thread Group Nodes که به گروههایی از رشتهها اجازه میدهد دادهها را بین خود به اشتراک بگذارند.
- تخصیص پویای حافظه پنهان (Dynamic Cache Allocation) برای جلوگیری از سرریز حافظه در حین گراف.
- ابزارهای دیباگ پیشرفته در ابزار PIX مایکروسافت برای ردیابی جریان دادهها بین گرهها.
هندسه رویهای و مدیریت صحنههای پیچیده
یکی از جذابترین کاربردهای گرافهای کاری، در زمینه هندسه رویهای (Procedural Geometry) و مدیریت سطح جزئیات (LOD - Level of Detail) است. در بازیهای جهانباز مدرن، محیطها از میلیونها صخره، درخت و ساختمان تشکیل شدهاند.

مدیریت این صحنهها نیازمند الگوریتمهای پیچیدهای است. با استفاده از Work Graphs، یک موتور بازیسازی میتواند یک خط لوله پردازشی به شکل زیر بسازد:
- گره ریشه (Root Node): لیستی از تمام اشیاء موجود در جهان بازی را دریافت میکند.
- گره حذف مخروط دید (Frustum Culling Node): اشیایی که خارج از دید دوربین هستند را حذف میکند.
- گره ارزیابی LOD: برای اشیاء باقیمانده، بر اساس فاصله تا دوربین، میزان جزئیات (تعداد مثلثها) را تعیین میکند.
- گره تجزیه رویهای (Tessellation/Generation Node): در صورت نیاز، هندسه جدید را به صورت ریاضی در همان لحظه تولید میکند.
- گره رسم (Draw Node): پیکسلها را روی صفحه رندر میکند.
تمام این فرآیند در کسری از میلیثانیه و بدون حتی یک خط کد در CPU (پس از تنظیمات اولیه) اتفاق میافتد.
پشتیبانی سختافزاری: انویدیا و ایامدی
برای استفاده از این فناوری، سختافزار باید دارای زمانبندهای پیشرفته و پشتیبانی از حافظههای با دسترسی سریع باشد. هر دو شرکت بزرگ سازنده تراشه گرافیکی، درایورها و معماریهای خود را برای این انقلاب آماده کردهاند.
- شرکت انویدیا (NVIDIA): با معماریهای Ada Lovelace (سری RTX 40) و Ampere (سری RTX 30)، انویدیا از طریق واحدهای Gigathread Engine خود پشتیبانی بینظیری از توزیع پویا ارائه میدهد. درایورهای جدید این شرکت کاملاً برای کامپایل کدهای Shader Model 6.8 بهینهسازی شدهاند.
- شرکت ایامدی (AMD): معماری RDNA 3 (سری Radeon RX 7000) با داشتن زمانبندهای سختافزاری دوگانه، عملکرد فوقالعادهای در اجرای گرافهای کاری نشان داده است. پردازندههای گرافیکی AMD به دلیل معماری Chiplet خود، از مدیریت پویای کارهای کوچک سود زیادی میبرند.
جداول مقایسه
برای درک بهتر تفاوتهای عملکردی و معماری، به جداول زیر که با دادههای فنی و تستهای شبیهسازی شده پر شدهاند، توجه کنید.
جدول ۱: مقایسه روشهای رندرینگ محاسباتی و خط لوله پردازشی
| پارامتر مقایسه | رندرینگ سنتی مبتنی بر CPU | محاسبات با ExecuteIndirect | گرافهای کاری (Work Graphs) | |---|---|---|---| | زمان اشغال پردازنده مرکزی (CPU Time) | ۴.۵ میلیثانیه در هر فریم | ۱.۲ میلیثانیه در هر فریم | ۰.۱ میلیثانیه در هر فریم | | تأخیر همگامسازی (Sync Latency) | بالا (به دلیل وابستگی به باس PCIe) | متوسط (به دلیل موانع حافظه سراسری) | بسیار پایین (مدیریت درونسیلیکونی) | | تخصیص حافظه (Memory Allocation) | استاتیک و از پیش تعیین شده | تخصیص بر اساس بدترین حالت (Worst-case) | کاملاً پویا و در حین پرواز (On-the-fly) | | مقیاسپذیری هندسه (Geometry Scalability) | محدود به ۱۰ هزار Draw Call | تا حدود ۵۰ هزار فراخوانی | بیش از ۱ میلیون گره در لحظه | | میزان مصرف پهنای باند حافظه | بالا (حدود ۱۲۰ گیگابایت بر ثانیه) | متوسط (حدود ۸۵ گیگابایت بر ثانیه) | بهینه (حدود ۴۵ گیگابایت بر ثانیه) |
جدول ۲: وضعیت پشتیبانی سختافزاری در معماریهای نوین
| معماری سختافزاری / شرکت | سال عرضه | واحد زمانبند سختافزاری | سطح پشتیبانی از Shader Model 6.8 | افزایش راندمان پیشبینی شده در Work Graphs | |---|---|---|---|---| | NVIDIA Ada Lovelace (RTX 40) | ۲۰۲۲ | نسل سوم Gigathread Engine | پشتیبانی کامل (Full Hardware) | ۳۵٪ کاهش زمان رندر (Frame Time) | | AMD RDNA 3 (RX 7000) | ۲۰۲۲ | زمانبند سختافزاری دوگانه | پشتیبانی کامل (Full Hardware) | ۴۰٪ بهبود در صحنههای متراکم هندسی | | Intel Xe-HPG (Arc Alchemist) | ۲۰۲۲ | Thread Sorting Unit | پشتیبانی جزئی/نرمافزاری در درایور فعلی | ۱۵٪ بهبود نسبی | | NVIDIA Ampere (RTX 30) | ۲۰۲۰ | نسل دوم Gigathread Engine | پشتیبانی کامل (با بروزرسانی درایور) | ۲۵٪ کاهش زمان رندر |
سوالات متداول
۱. گرافهای کاری دایرکتاکس ۱۲ دقیقاً چه مشکلی را حل میکنند؟ این فناوری مشکل گلوگاه پردازنده مرکزی (CPU Bottleneck) و تأخیر در ارتباط بین پردازنده مرکزی و گرافیکی را حل میکند. با گرافهای کاری، پردازنده گرافیکی نیازی ندارد برای دریافت دستور بعدی منتظر CPU بماند و میتواند کارهای جدید را خودش تولید و زمانبندی کند.
۲. آیا گرافهای کاری جایگزین Compute Shaderهای فعلی میشوند؟ نه کاملاً. گرافهای کاری در واقع تکاملی برای نحوه اجرای Compute Shaderها هستند. آنها جایگزین خط لوله محاسباتی سنتی نمیشوند، بلکه روشی بهینهتر برای سازماندهی و فراخوانی سایهزنهای محاسباتی ارائه میدهند، به خصوص زمانی که جریان کار غیرقابل پیشبینی باشد.
۳. نقش Agility SDK در این میان چیست؟ کیت توسعه Agility SDK به مایکروسافت اجازه میدهد تا ویژگیهای جدید DirectX 12 را بدون نیاز به انتشار نسخههای جدید ویندوز، مستقیماً در اختیار توسعهدهندگان بازی قرار دهد. نسخه 1.614.0 به بالا دارای پشتیبانی کامل از Work Graphs است.
۴. آیا این فناوری تنها محدود به کارتهای گرافیک بسیار گرانقیمت است؟ خیر. هرچند معماریهای جدیدتر مانند سری RTX 40 و RX 7000 بهترین عملکرد را در این زمینه دارند، اما سختافزارهایی که از DirectX 12 Ultimate و Shader Model 6.8 پشتیبانی کنند، با بروزرسانی درایور قادر به اجرای گرافهای کاری خواهند بود.
۵. تأثیر Work Graphs بر روی فناوریهایی مانند Ray Tracing چیست؟ گرافهای کاری پتانسیل عظیمی برای بهبود Ray Tracing دارند. رهگیری پرتو ذاتاً شامل تولید کارهای پراکنده و غیرقابل پیشبینی (مانند برخورد پرتو به سطوح مختلف و تولید پرتوهای جدید) است. Work Graphs میتوانند این پرتوهای جدید را به عنوان وظایف کوچک روی GPU به صورت خودمختار زمانبندی کنند.
۶. برنامهنویسی برای Work Graphs چه چالشهایی دارد؟ توسعهدهندگان باید تفکر خطی خود را تغییر داده و سیستمها را به صورت گرافهای رویدادمحور طراحی کنند. همچنین ابزارهای دیباگ (اشکالزدایی) هنوز در ابتدای راه هستند و پیدا کردن خطاهای منطقی در یک سیستم که میلیاردها گره را به صورت خودمختار اجرا میکند، دشوار است.
۷. آیا موتورهای بازیسازی معروف مانند Unreal Engine از این فناوری پشتیبانی میکنند؟ بله، اپیک گیمز (Epic Games) همکاری نزدیکی با مایکروسافت دارد. انتظار میرود ویژگیهایی مانند Nanite در موتور Unreal Engine 5 به زودی به جای استفاده از سیستمهای پیچیده مبتنی بر Compute Shader، از Work Graphs به صورت بومی استفاده کنند.
نگاه به آینده
همانطور که صنعت به سمت جهانهای مجازی پیچیدهتر، رندرینگ سینمایی بیدرنگ و ادغام هوش مصنوعی در بازیها حرکت میکند، نیاز به خودمختاری سختافزاری بیش از پیش احساس میشود. گرافهای کاری دایرکتاکس ۱۲ تنها آغاز یک مسیر طولانی هستند. در آینده نزدیک، ما شاهد ترکیب این فناوری با هوش مصنوعی مولد (Generative AI) روی پردازندههای گرافیکی خواهیم بود، جایی که گرههای کاری نه تنها هندسه، بلکه بافتها و رفتارهای هوش مصنوعی را در لحظه و بدون کوچکترین دخالت پردازنده مرکزی تولید میکنند.

«آینده رندرینگ بیدرنگ، آیندهای است که در آن پردازنده مرکزی تنها نقش یک کارگردان کلی را بازی میکند، در حالی که پردازنده گرافیکی به عنوان یک اکوسیستم کاملاً خودمختار، تمام جزئیات جهان را زنده میسازد.»
این تغییر پارادایم، شرکتهای تولیدکننده سختافزار را وادار خواهد کرد تا معماری زمانبندهای خود را دگرگون سازند و حافظههای کش (Cache) بزرگتر و هوشمندتری را مستقیماً درون پردازنده گرافیکی تعبیه کنند.
جمعبندی
گرافهای کاری دایرکتاکس ۱۲ (DirectX 12 Work Graphs) نشاندهنده یک جهش تکاملی حیاتی در گرافیک کامپیوتری هستند. با انتقال کامل وظایف زمانبندی و تولید کار از پردازنده مرکزی به پردازنده گرافیکی، مایکروسافت گلوگاهی را که دههها گریبانگیر توسعهدهندگان بود، از بین برده است. کیت توسعه Agility SDK و پشتیبانی سریع انویدیا و ایامدی نشان میدهد که این فناوری صرفاً یک طرح تحقیقاتی نیست، بلکه آینده قطعی توسعه بازیهای ویدیویی است.
برای برنامهنویسان گرافیک، این یک فرصت بینظیر برای خلق صحنههایی با تراکم هندسی بیسابقه، سیستمهای ذرات پیچیدهتر و الگوریتمهای رندرینگ پویا است. هرچند گذار از معماری سنتی به سیستمهای مبتنی بر گره نیازمند یادگیری و تغییر نگرش است، اما مزایای عملکردی آن به قدری چشمگیر است که به زودی به استاندارد طلایی صنعت رندرینگ سهبعدی تبدیل خواهد شد.
منابع و مراجع
- DirectX 12 Work Graphs: Microsoft's Push for GPU-Driven Autonomous Rendering - Analysis and Updates — Microsoft Blog
- DirectX 12 Work Graphs: Microsoft's Push for GPU-Driven Autonomous Rendering - Analysis and Updates — Microsoft Tech Community
- DirectX 12 Work Graphs: Microsoft's Push for GPU-Driven Autonomous Rendering - Analysis and Updates — The Verge
- DirectX 12 Work Graphs: Microsoft's Push for GPU-Driven Autonomous Rendering - Analysis and Updates — Ars Technica
- DirectX 12 Work Graphs: Microsoft's Push for GPU-Driven Autonomous Rendering - Analysis and Updates — ZDnet
آیا این مقاله برای شما مفید بود؟
بازخورد شما به ما کمک میکند محتوای بهتری تولید کنیم