ساخت هوش مصنوعی سازمانی مقیاسپذیر و امن: راهنمای معماری RAG با Azure OpenAI
Building Scalable and Secure Enterprise AI: A Guide to RAG Architectures with Azure OpenAI Service
با استفاده از معماری تولید افزوده بازیابی (RAG) در سرویس Azure OpenAI، سازمانها میتوانند بدون نیاز به آموزش مجدد مدلهای زبانی، هوش مصنوعی را با دادههای خصوصی خود یکپارچه کنند. این مقاله به بررسی امنیت، مقیاسپذیری و بهینهسازی هزینهها میپردازد.
1. مقدمه
در دنیای پرشتاب فناوری امروز، ظهور مدلهای زبانی بزرگ (LLM) تحولی شگرف در نحوه تعامل ماشینها و انسانها ایجاد کرده است. از اواخر سال ۲۰۲۲ و با معرفی عمومی ChatGPT، سازمانها به سرعت متوجه پتانسیل عظیم این فناوری برای خودکارسازی فرآیندها، بهبود پشتیبانی مشتری و تحلیل دادههای پیچیده شدند. با این حال، یک چالش اساسی همواره پیش روی شرکتهای بزرگ قرار داشته است: حفظ حریم خصوصی دادههای سازمانی در کنار استفاده از هوش مصنوعی قدرتمند.
«هوش مصنوعی سازمانی تنها زمانی ارزشآفرین است که بتواند با امنترین استانداردهای موجود، به عمیقترین دادههای خصوصی سازمان دسترسی پیدا کند، بدون آنکه این دادهها را به بیرون درز دهد.»
برای حل این مشکل، رویکرد تولید افزوده بازیابی (Retrieval-Augmented Generation) یا به اختصار RAG معرفی شد. این معماری به مدلهای زبانی اجازه میدهد تا به جای تکیه صرف بر دانشی که با آن آموزش دیدهاند، با دادههای خصوصی سازمانی تعامل داشته باشند؛ آن هم بدون نیاز به تنظیم دقیق (Fine-Tuning) پرهزینه مدلهای سفارشی.
سرویس Azure OpenAI مایکروسافت، با ارائه قابلیتهای امنیتی در سطح سازمانی مانند Private Link و Managed Identities، بستری فراهم کرده است تا اطلاعات حساس شرکتها محافظت شود. در این مقاله جامع، به بررسی عمیق معماری RAG در Azure، نحوه استقرار امن آن و روشهای بهینهسازی عملکرد و هزینهها برای مقیاسهای بزرگ سازمانی میپردازیم.
2. بافت و پیشزمینه
مدلهای پایه (Foundational Models) مانند GPT-4 بر روی حجم وسیعی از دادههای عمومی آموزش دیدهاند، اما از اطلاعات اختصاصی درونسازمانی مانند آییننامههای داخلی، سوابق مشتریان یا اسناد مالی بیخبرند. در گذشته، تنها راه حل این مشکل، تنظیم دقیق (Fine-tuning) مدل با دادههای جدید بود. این فرآیند نه تنها نیازمند توان محاسباتی بالا و زمان طولانی است، بلکه در صورت تغییر روزانه دادهها، مدل به سرعت منسوخ میشود.
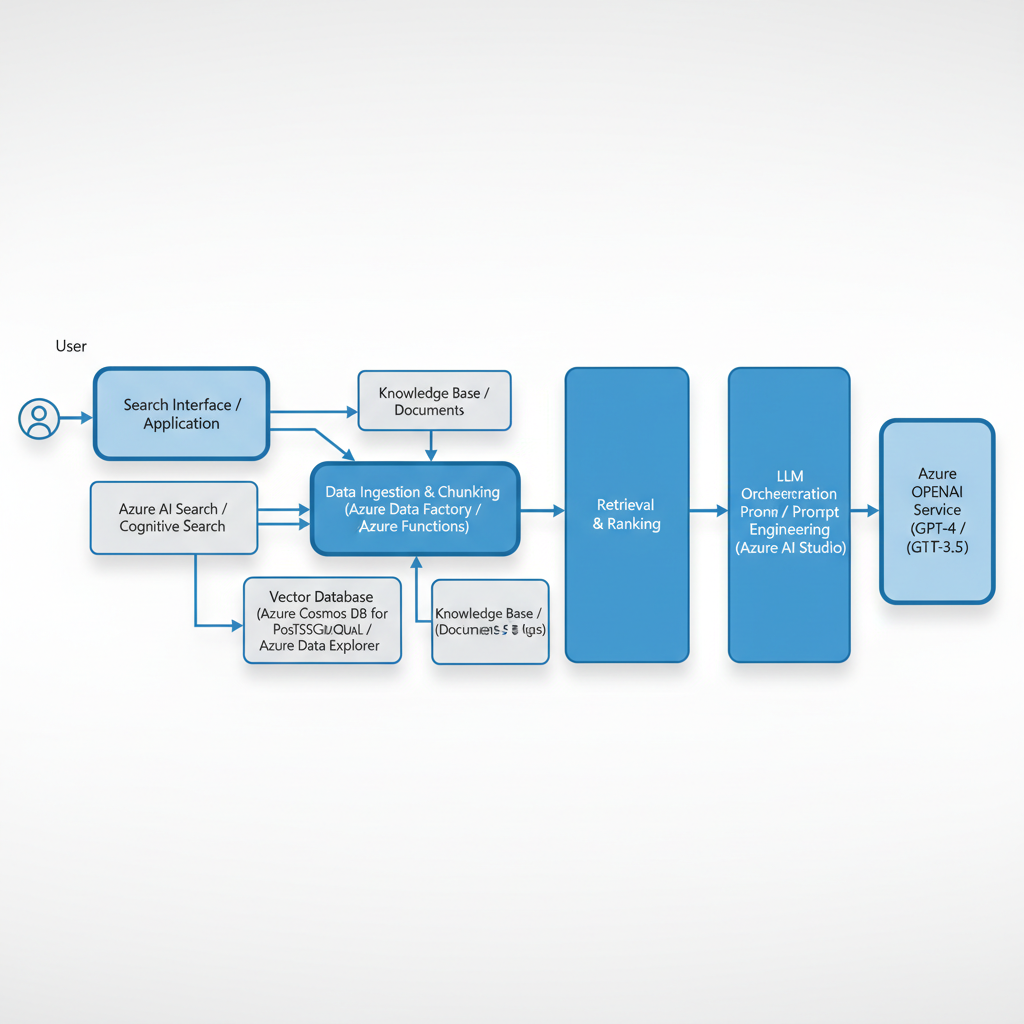
معماری RAG به عنوان یک راهکار انقلابی ظاهر شد. در این روش، درخواست کاربر ابتدا به یک پایگاه داده جستجو (مانند Azure AI Search) ارسال میشود تا مرتبطترین اسناد بازیابی شوند. سپس این اسناد به عنوان «زمینه» (Context) به همراه درخواست اولیه کاربر به LLM ارسال میگردند. در نتیجه، مدل پاسخی دقیق، مبتنی بر اسناد داخلی و قابل ارجاع تولید میکند.
چرا Azure OpenAI؟
بزرگترین نگرانی مدیران ارشد فناوری (CTOها) در پیادهسازی هوش مصنوعی، امنیت دادهها است. مایکروسافت در سرویس Azure OpenAI تعهدات قانونی و فنی سفت و سختی را ارائه میدهد. دادههایی که در محیط Azure پردازش میشوند، هرگز برای آموزش مدلهای پایه جهانی OpenAI استفاده نمیشوند. این بدان معناست که اسرار تجاری شما به طور ناخواسته در خروجی سایر کاربران در سراسر جهان ظاهر نخواهد شد.
مزایای کلیدی استفاده از RAG در مقایسه با روشهای سنتی عبارتند از:
- کاهش توهم (Hallucination): مدل تنها بر اساس اسناد بازیابی شده پاسخ میدهد.
- بهروزرسانی آنی: با افزودن یک سند جدید به پایگاه داده، هوش مصنوعی بلافاصله آن را در پاسخهای خود لحاظ میکند.
- قابلیت ارجاع (Traceability): هر پاسخ دارای رفرنسی به سند اصلی است.
- کنترل دسترسی: کاربران تنها بر اساس سطح دسترسی خود میتوانند اطلاعات را بازیابی و از هوش مصنوعی بپرسند.
- کاهش هزینههای آموزش: نیازی به پردازشهای گرافیکی (GPU) سنگین برای آموزش مجدد مدل نیست.
3. جزئیات و تحلیل
برای ساخت یک سیستم سازمانی که هم مقیاسپذیر باشد و هم امن، باید معماری خط لوله (Pipeline) را به دقت طراحی کرد. این بخش به بررسی فنی اجزای مختلف این معماری میپردازد.
3.1. معماری خط لوله RAG با استفاده از Azure AI Search
قلب تپنده هر سیستم RAG، موتور جستجو و بازیابی آن است. Azure AI Search به عنوان جزء حیاتی پایگاه داده برداری (Vector Database) عمل میکند که مسئولیت نمایهسازی (Indexing) و بازیابی اسناد داخلی مرتبط را بر عهده دارد.
مراحل اصلی پردازش و بازیابی دادهها در این معماری به شرح زیر است:
- استخراج و پاکسازی دادهها (Data Ingestion): اسناد سازمانی (PDF، Word، پایگاههای داده SQL) توسط سرویسهایی مانند Azure Data Factory استخراج شده و به متن خام تبدیل میشوند.
- تقسیمبندی متن (Chunking): از آنجا که مدلهای زبانی دارای محدودیت پنجره زمینه (Context Window) هستند (به عنوان مثال 128K توکن در GPT-4 Turbo)، متنها به قطعات کوچکتر (معمولاً 512 تا 1024 توکن) با همپوشانی (Overlap) حدود 10 الی 20 درصدی تقسیم میشوند تا معنای جملات در مرز قطعات از بین نرود.
- تولید بردار (Embedding): هر قطعه متن با استفاده از مدلهایی مانند
text-embedding-3-largeبه یک فضای برداری با ابعاد بالا (مثلاً 3072 بعد) تبدیل میشود. این بردارها معنای مفهومی متن را در خود جای میدهند. - نمایهسازی و ذخیرهسازی: بردارهای تولید شده به همراه فرادادهها (Metadata) در Azure AI Search ذخیره میشوند. این سرویس از الگوریتم HNSW برای جستجوی تقریبی نزدیکترین همسایه (ANN) استفاده میکند که زمان پاسخگویی را به چند میلیثانیه کاهش میدهد.
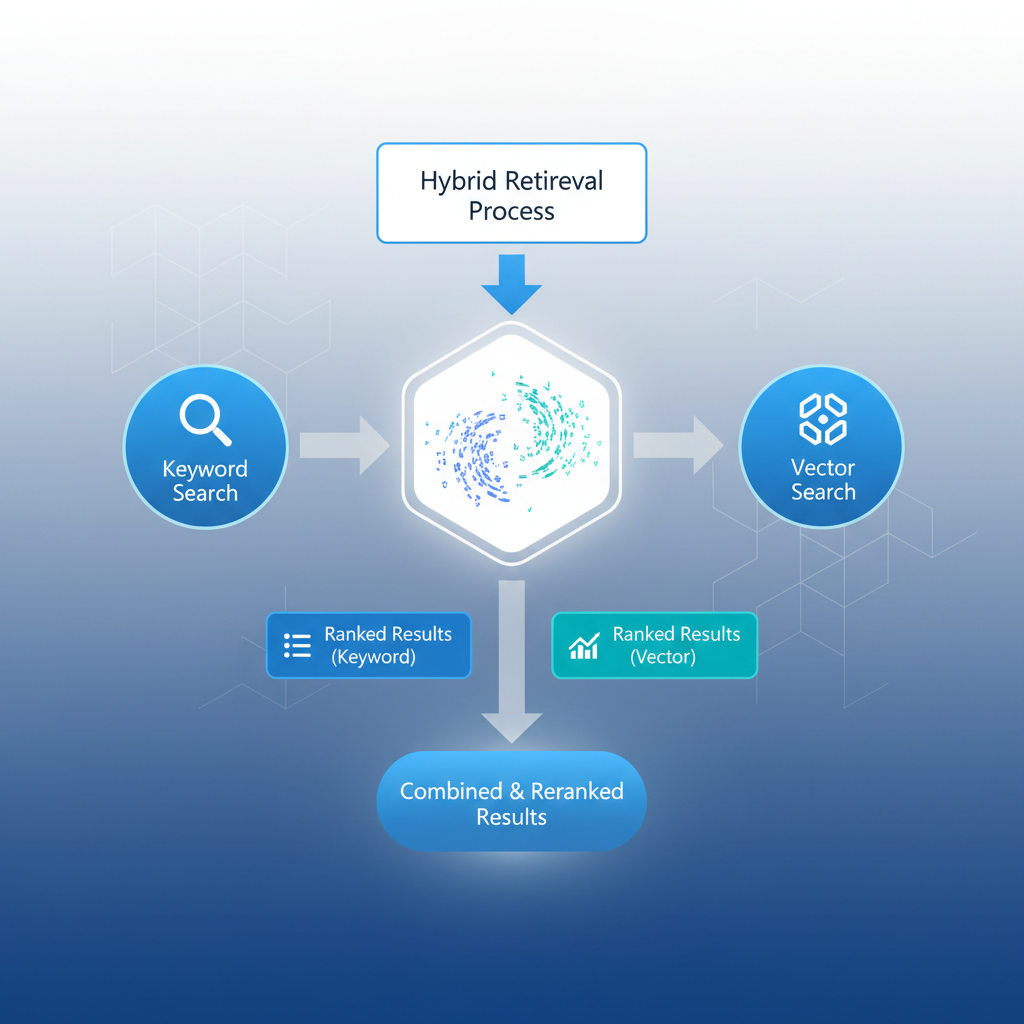
- جستجوی ترکیبی (Hybrid Search): هنگام درخواست کاربر، Azure AI Search همزمان یک جستجوی کلیدواژهای (BM25) و یک جستجوی برداری (Vector Search) انجام داده و نتایج را با استفاده از مدلهای رتبهبندی معنایی (Semantic Ranker) ترکیب میکند تا دقیقترین نتایج استخراج شود.
3.2. ایمنسازی بارهای کاری هوش مصنوعی با شبکههای مجازی Azure
در محیطهای سازمانی مانند بانکها، بیمارستانها یا نهادهای دولتی، دسترسی عمومی به APIها (Public Endpoints) یک ریسک غیرقابل قبول است. سرویس Azure OpenAI ویژگیهای امنیتی در سطح سازمانی را برای محافظت از اطلاعات حساس شرکتی ارائه میدهد.
برای ایمنسازی کامل معماری هوش مصنوعی، مراحل زیر پیادهسازی میشوند:
- ایجاد شبکه مجازی (Azure VNet): تمام منابع (برنامههای وب، دیتابیسها، سرویسهای AI) درون یک شبکه مجازی محصور قرار میگیرند که از اینترنت عمومی ایزوله است.
- استفاده از Azure Private Link: با این فناوری، سرویس Azure OpenAI یک آدرس IP خصوصی از داخل VNet شما دریافت میکند. بدین ترتیب ترافیک بین برنامه شما و هوش مصنوعی هرگز از بستر اینترنت عمومی عبور نمیکند و مستقیماً از طریق شبکه زیرساخت جهانی مایکروسافت (Microsoft Backbone) هدایت میشود.
- هویتهای مدیریت شده (Managed Identities): به جای استفاده از کلیدهای API (که خطر لو رفتن دارند)، از Azure Entra ID (اکتیو دایرکتوری سابق) استفاده میشود. برنامهها به طور خودکار هویتسنجی شده و تنها بر اساس نقشهای تعریف شده (RBAC) مجوز اجرای درخواستها را دارند.
- رمزنگاری کلیدهای مدیریت شده توسط مشتری (CMK): تمامی دادههای در حال استراحت (Data at Rest) میتوانند با کلیدهای رمزنگاری که منحصراً توسط خود سازمان در Azure Key Vault مدیریت میشوند، رمزنگاری گردند.
«طبق سیاستهای رسمی حفظ حریم خصوصی مایکروسافت، دادههای پردازش شده در سرویس Azure OpenAI برای آموزش مدلهای پایه 글로벌 OpenAI استفاده نمیشوند و مشتریان مالکیت و کنترل کامل بر دادههای خود دارند.»

3.3. بهینهسازی عملکرد و هزینههای توکن برای استقرار گسترده
پیادهسازی هوش مصنوعی در مقیاس چند هزار کاربر سازمانی میتواند هزینههای غیرقابل پیشبینی به همراه داشته باشد. در معماری RAG، هر پرسش شامل ارسال حجم زیادی از اسناد به عنوان پیشزمینه (Prompt) است. مدیریت هوشمند توکنها در اینجا نقش تعیینکنندهای دارد.
تکنیکهای کلیدی بهینهسازی:
- فیلتر کردن پیشرفته فراداده (Metadata Filtering): قبل از جستجوی برداری، از فیلترهای سنتی برای محدود کردن فضای جستجو (مانند تاریخ یا دپارتمان خاص) استفاده کنید تا حجم دادههای ارسالی به LLM کاهش یابد.
- فشردهسازی پرامپت (Prompt Compression): استفاده از مدلهای کوچکتر (مانند GPT-3.5-Turbo یا مدلهای متنباز مبتنی بر SLM) برای خلاصهسازی اسناد استخراج شده قبل از ارسال آنها به مدل اصلی (GPT-4).
- مدیریت ظرفیت پردازشی (PTU در برابر PAYG): برای سازمانهایی که ترافیک پیشبینیپذیر و بالایی دارند، مایکروسافت مدل قیمتگذاری Provisioned Throughput Units (PTU) را پیشنهاد میدهد. برخلاف مدل Pay-As-You-Go (PAYG) که بر اساس هر توکن هزینه دریافت میشود، در PTU شما یک ظرفیت پردازشی ثابت ماهانه را اجاره میکنید که میتواند تا ۶۰ درصد در مقیاس بالا صرفهجویی مالی به همراه داشته باشد.
- کَش کردن معنایی (Semantic Caching): با ذخیره پاسخهای قبلی در دیتابیسی مانند Redis، اگر کاربر پرسشی مشابه (نه لزوماً با کلمات دقیقاً یکسان) بپرسد، پاسخ بدون فراخوانی مجدد LLM مستقیماً از حافظه کش بازگردانده میشود.

3.4. پیادهسازی فیلترهای ایمنی محتوا (Content Safety)
استفاده از هوش مصنوعی خطراتی نظیر تولید محتوای توهینآمیز، افشای اطلاعات هویتی (PII) یا حملات تزریق پرامپت (Prompt Injection) را در پی دارد. سرویس Azure AI Content Safety یک لایه محافظتی یکپارچه است که هم ورودیهای کاربر و هم خروجیهای مدل را به صورت درنگزمان (Real-time) پایش میکند.
سازمانها میتوانند فیلترهای نظارتی را در دستههای زیر تنظیم و شدت حساسیت (Low, Medium, High) آنها را مدیریت کنند:
- محتوای نفرتانگیز و نژادپرستانه (Hate & Fairness)
- محتوای جنسی (Sexual Content)
- ترویج خشونت و آسیب به خود (Violence & Self-Harm)
- تشخیص و جلوگیری از فرار از قید (Jailbreak Detection)
- شناسایی محتوای دارای حق چاپ (Protected Material Detection)
این فیلترها تضمین میکنند که خروجیهای تولید شده کاملاً با قوانین تطابق (Compliance) سازمان و نهادهای نظارتی همخوانی دارند.
4. جدول مقایسه
برای درک بهتر تفاوت استراتژیهای پیادهسازی و همچنین مدلهای قیمتگذاری، در این بخش دو جدول مقایسهای جامع با دادههای کاربردی آورده شده است.
جدول ۱: مقایسه رویکردهای اصلی یکپارچهسازی دادههای سازمانی با LLM
| ویژگی | معماری تولید افزوده بازیابی (RAG) | تنظیم دقیق (Fine-Tuning) | رویکرد مهندسی پرامپت ساده (بدون بازیابی) | |---|---|---|---| | هزینه راهاندازی اولیه | متوسط (نیاز به پایگاه داده و خط لوله داده) | بسیار بالا (هزینه سرورهای GPU و متخصصان داده) | بسیار پایین | | هزینه اجرای روزمره (Inference) | متوسط تا بالا (به دلیل طولانی شدن پرامپت با اسناد) | پایینتر (مدل از قبل دانش را درونی کرده است) | پایین (فقط سوال کاربر ارسال میشود) | | بهروزرسانی دانش | آنی (در عرض چند ثانیه با بروزرسانی دیتابیس) | زمانبر (نیازمند آموزش دورهای مجدد) | غیرممکن (مدل به دانش جدید دسترسی ندارد) | | احتمال توهم (Hallucination) | بسیار پایین (محدود به اسناد ارائه شده) | متوسط (مدل ممکن است مفاهیم را ترکیب کند) | بسیار بالا در موضوعات تخصصی | | شفافیت و ارجاعدهی | عالی (میتواند دقیقاً ذکر کند پاسخ از کدام پاراگراف سند است) | ضعیف (نمیتوان فهمید مدل از کدام داده آموزشی استفاده کرده) | ناموجود |
<br>جدول ۲: مقایسه مدلهای قیمتگذاری و مدیریت هزینه در Azure OpenAI
| مدل قیمتگذاری | نحوه محاسبه هزینه | پهنای باند و تاخیر (Latency) | مناسبترین سناریوی کاربردی | صرفهجویی در مقیاس کلان (درصد تخمینی) | |---|---|---|---|---| | Pay-As-You-Go (PAYG) | بر اساس هر ۱۰۰۰ توکن پردازش شده (ورودی و خروجی) | متغیر بر اساس بار شبکه عمومی Azure | توسعه اولیه (PoC)، استارتاپها، ترافیک غیرقابل پیشبینی | ۰٪ (قیمت پایه استاندارد) | | Provisioned Throughput (PTU) | هزینه ثابت ماهانه برای اجاره ظرفیت پردازشی تضمین شده | بسیار پایین و پایدار (منابع اختصاصی) | سیستمهای حیاتی تولید (Production)، بانکها با بیش از ۵۰ هزار کاربر روزانه | تا ۷۰٪ کاهش هزینه در صورت استفاده کامل از ظرفیت | | Global Standard | توزیع هوشمند بار پردازشی در سراسر دیتاسنترهای جهانی مایکروسافت | متوسط (بسته به منطقه هدایت شده) | کاربردهایی که نیازمند در دسترس بودن (Availability) ۹۹.۹۹٪ هستند | حدود ۱۰ تا ۲۰٪ بهینهسازی به دلیل عدم نیاز به افزونگی محلی |
5. سوالات متداول
در روند استقرار هوش مصنوعی در سازمانها، مدیران فناوری معمولاً سوالات کلیدی و مشترکی دارند. در اینجا به رایجترین این پرسشها پاسخ داده شده است:
پرسش ۱: آیا در معماری RAG، محدودیت تعداد اسناد برای جستجو وجود دارد؟ پاسخ: در Azure AI Search محدودیتی در تعداد کل اسناد نمایهسازی شده وجود ندارد (تا میلیاردها رکورد). با این حال، در زمان بازیابی نتایج، شما باید تنها چند سند برتر (مثلاً ۵ تا ۱۰ قطعه متن برتر) را انتخاب کنید تا از حد مجاز توکنهای پنجره زمینه LLM فراتر نروید.
پرسش ۲: تفاوت جستجوی برداری (Vector Search) با جستجوی کلیدواژهای در چیست؟ پاسخ: جستجوی کلیدواژهای تنها به دنبال تطابق دقیق کلمات میگردد (مثل موتورهای جستجوی قدیمی). اما جستجوی برداری، مفهوم و معنای عبارات را درک میکند. به عنوان مثال، اگر کاربر بپرسد «تسهیلات خرید مسکن»، سیستم برداری میتواند اسنادی با کلمات «وام آپارتمان» را نیز پیدا کند، حتی اگر هیچ کلمه مشترکی نداشته باشند.
پرسش ۳: آیا مایکروسافت میتواند به دادههای نمایهسازی شده ما دسترسی پیدا کند؟ پاسخ: خیر. طبق مستندات و قراردادهای حقوقی Azure (DPA)، دادههای شما در بستر اختصاصی خودتان باقی میمانند. کلیدهای رمزنگاری میتوانند در انحصار شما باشند و مهندسان مایکروسافت هیچگونه دسترسی مستقیمی به دیتابیسهای شما ندارند.
پرسش ۴: نرخ تاخیر (Latency) در سیستمهای RAG چقدر است و چگونه میتوان آن را کاهش داد؟ پاسخ: تاخیر معمولاً بین ۲ الی ۶ ثانیه متغیر است. بخش عمده این زمان مربوط به تولید پاسخ توسط LLM است. برای کاهش آن میتوانید از مدلهای سریعتر (مثل GPT-4o-mini)، استریم کردن پاسخ (Streaming Response) به کاربر، و همچنین پیادهسازی Semantic Caching استفاده کنید.
پرسش ۵: چگونه از تکنیکهای تزریق پرامپت (Prompt Injection) جلوگیری کنیم؟ پاسخ: استفاده از ابزار Azure AI Content Safety به صورت توکار حملات Jailbreak را تشخیص میدهد. علاوه بر این، دستورات سیستمی (System Prompts) باید با دقت طراحی شوند تا صراحتاً به مدل دستور دهند از هیچ دستوری خارج از چارچوب تعریف شده پیروی نکند.
پرسش ۶: آیا میتوان مدلهای متنباز (Open-Source) را با معماری RAG در Azure پیاده کرد؟ پاسخ: بله. سرویس Azure AI Studio شامل صدها مدل متنباز از جمله Llama 3، Mistral و Phi-3 است که میتوانند به جای مدلهای OpenAI در خط لوله RAG استقرار یابند و از همان مزایای امنیتی شبکه بهرهمند شوند.
پرسش ۷: چه تفاوتی بین Semantic Ranker و جستجوی استاندارد وجود دارد؟ پاسخ: جستجوی استاندارد (حتی برداری) ممکن است نتایج را بر اساس شباهت ریاضیاتی مرتب کند که همیشه برای انسان منطقی نیست. Semantic Ranker از یک مدل هوش مصنوعی ثانویه (آموزش دیده توسط موتور بینگ) استفاده میکند تا نتایج اولیه را دوباره بررسی کرده و آنها را بر اساس بیشترین میزان پاسخگویی به نیت (Intent) کاربر، مجدداً رتبهبندی کند.
6. نگاه به آینده
تکامل هوش مصنوعی سازمانی متوقف نخواهد شد. در آیندهای نه چندان دور، معماریهای RAG از حالت متنی صرف خارج شده و به سمت Multi-modal RAG (بازیابی چندوجهی) حرکت خواهند کرد. با استفاده از مدلهایی مانند GPT-4o، سیستمها قادر خواهند بود علاوه بر متن، جداول پیچیده درون تصاویر، نمودارهای مالی و فایلهای صوتی ضبط شده جلسات را نیز مستقیماً درک و تحلیل کنند.
علاوه بر این، ظهور عاملهای هوشمند خودکار (Autonomous AI Agents) رویکرد جدیدی است که در آن، هوش مصنوعی تنها به پاسخ دادن اکتفا نمیکند؛ بلکه میتواند در سیستمهای سازمانی اقداماتی انجام دهد (مانند ثبت مرخصی در سامانه منابع انسانی یا تولید پیشنویس قرارداد در سیستم CRM). مایکروسافت چارچوبهایی مانند AutoGen و ابزارهای Copilot Studio را برای تسریع این روند یکپارچه کرده است که نویدبخش تبدیل سازمانها به اکوسیستمهای مبتنی بر هوش مصنوعی فعال است.

7. جمعبندی
پیادهسازی موفقیتآمیز هوش مصنوعی در محیطهای سازمانی نیازمند ایجاد تعادلی ظریف میان نوآوری، امنیت و مدیریت هزینههاست. استفاده از مدلهای زبانی عمومی برای دادههای خصوصی دیگر یک گزینه عملی نیست. معماری تولید افزوده بازیابی (RAG) ثابت کرده است که کارآمدترین رویکرد برای پل زدن بین قدرت تفکر LLMها و گنجینه دادههای خصوصی سازمانهاست.
«آینده رقابت در دنیای کسبوکار، نه به داشتن دادههای بیشتر، بلکه به توانایی پرسشگری موثرتر از آن دادهها بستگی دارد.»
با بهرهگیری از زیرساختهای یکپارچه Azure OpenAI Service در کنار Azure AI Search و استفاده از ابزارهای امنیتی و شبکهای قدرتمند پلتفرم مایکروسافت، شرکتها میتوانند پلتفرمهای هوشمند سازمانی بسازند که نه تنها در برابر تهدیدات سایبری مقاوماند، بلکه با حفظ انطباق با مقررات و مدیریت هوشمند هزینهها، بازگشت سرمایه (ROI) سریعی را به همراه دارند. اکنون زمان آن فرا رسیده است که سازمانها از مرحله آزمایشگاهی (PoC) عبور کرده و پیادهسازی سیستمهای RAG در ابعاد واقعی تولید را آغاز کنند.
منابع و مراجع
- Building Scalable and Secure Enterprise AI: A Guide to RAG Architectures with Azure OpenAI Service - Analysis and Updates — Microsoft Blog
- Building Scalable and Secure Enterprise AI: A Guide to RAG Architectures with Azure OpenAI Service - Analysis and Updates — Microsoft Tech Community
- Building Scalable and Secure Enterprise AI: A Guide to RAG Architectures with Azure OpenAI Service - Analysis and Updates — The Verge
- Building Scalable and Secure Enterprise AI: A Guide to RAG Architectures with Azure OpenAI Service - Analysis and Updates — Ars Technica
- Building Scalable and Secure Enterprise AI: A Guide to RAG Architectures with Azure OpenAI Service - Analysis and Updates — ZDnet
آیا این مقاله برای شما مفید بود؟
بازخورد شما به ما کمک میکند محتوای بهتری تولید کنیم